海灘垃圾調查通常要靠人到現場觀察、記錄與分類,很花人力,也很難長期追蹤大範圍的海灘。2023 年 5 月到 2025 年 2 月,我在大學專題裡和四位同學一起做了一套海灘垃圾自動監測系統:與澎湖海洋公民基金會合作,用無人機航拍影像結合影像處理與深度學習,自動辨識海灘上的垃圾,再換算成量化指標。專題曾獲全國大專院校競賽獎項與校內專題研究獎。
這篇整理系統怎麼運作、我負責的部分,以及模型在測試集上的實際表現。圖表都取自我們的專題論文。
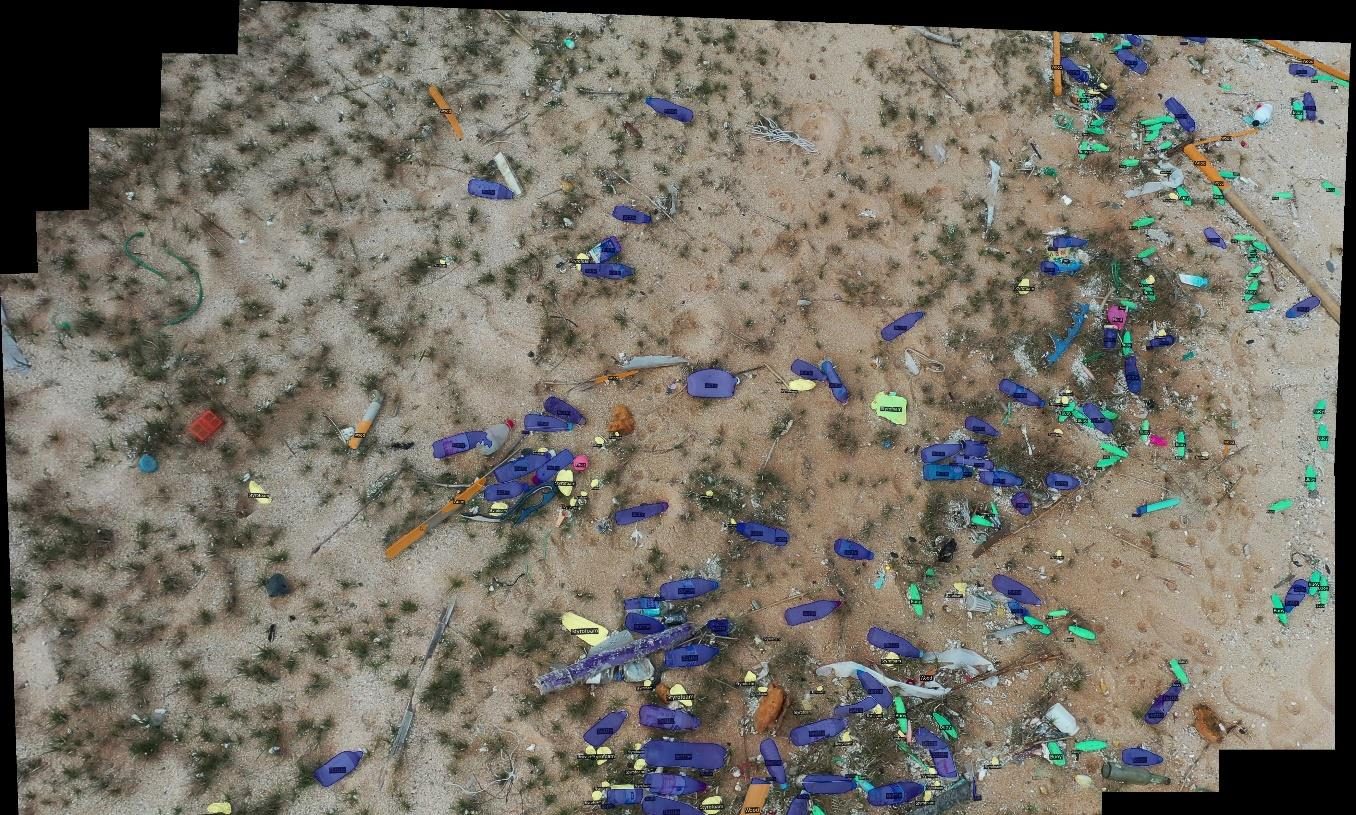
海灘全景影像上的垃圾辨識結果(取自專題論文圖 7.12)。
研究問題與分工
這個專題想做的事,是用無人機航拍影像建立一套自動化的海灘垃圾辨識與量化流程,取代一部分原本靠人工目視的調查。
專題是五人團隊的研究。我負責資料與模型:
- 整理影像資料集與分割標註
- 格式轉換與前處理
- 撰寫少數類別的資料增強程式
- 訓練與測試 CenterMask2
- 分析實驗結果並製作圖表
系統流程
flowchart TD
    V["UAV 航拍影片"] --> F["擷取影格"]
    F --> S["OpenCV 影像拼接"]
    S --> P["海灘全景影像"]
    S --> O["找出相鄰影格的重疊區域"]
    O --> N["無重疊區域影像"]
    N --> T["影像預處理<br/>切成 640 × 480"]
    T --> M["CenterMask2<br/>實例分割"]
    M --> R["辨識結果影像"]
    R --> C["影像重構"]
    C --> D["拼接成<br/>海灘垃圾分布地圖"]
    M --> K["各類垃圾統計"]
    K --> I["海灘指數計算<br/>CCI · PAI"]
航拍影片先切成影格,接著分成兩路。
一路由團隊以 OpenCV 把影格拼接成海灘全景。
另一路負責辨識。相鄰影格拍到的範圍會重疊,同一件垃圾可能被辨識兩次,所以先找出影格之間的重疊區域並把它遮掉,再把影像切成 640 × 480 的小影像(原始影格是 3840 × 2160,直接送進模型的運算量太大),送進 CenterMask2 做實例分割。
辨識結果會重構回原本的影格大小,再拼接成海灘垃圾分布地圖,也就是文章開頭那張圖。系統同時依類別統計垃圾的數量與面積,計算海灘清潔指數(CCI)與塑膠豐度指數(PAI)。
資料與標註
我們標註了五類垃圾:保麗龍、寶特瓶、木材、浮標、浮球。每一類對應一種顏色,把影像裡每個物件的輪廓逐一標出來,作為實例分割的訓練標籤。
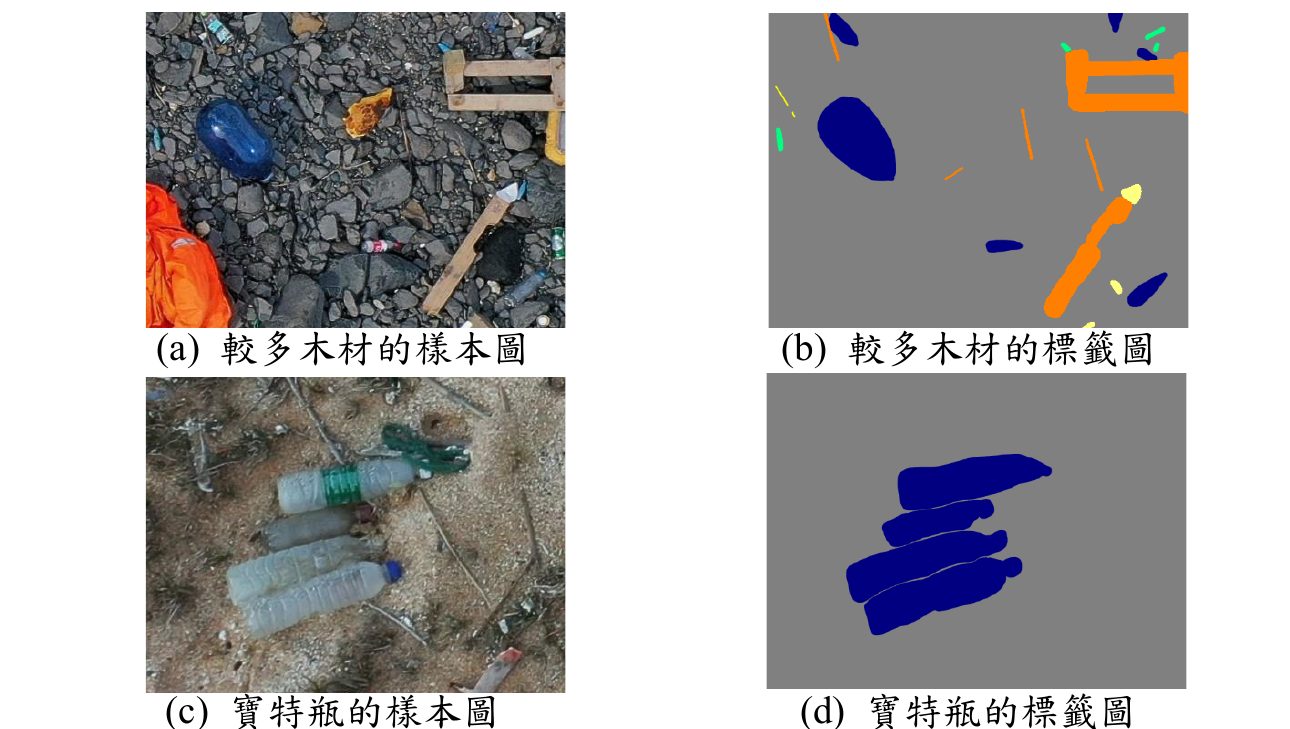
訓練樣本與分割標註範例(取自專題論文圖 7.5)。
處理類別不平衡
各類別的樣本數差距很大。原始資料中,浮球只有 1,727 個標註,寶特瓶和保麗龍則分別有約 2.5 萬與 2.7 萬個。差距這麼大,模型容易偏向樣本多的類別。
我寫了一支資料增強程式來處理這個問題:把浮標、木材和浮球這些少數類別的物件,連同標註一起複製,經過旋轉、縮放後,貼到影像中沒有標註的區域。
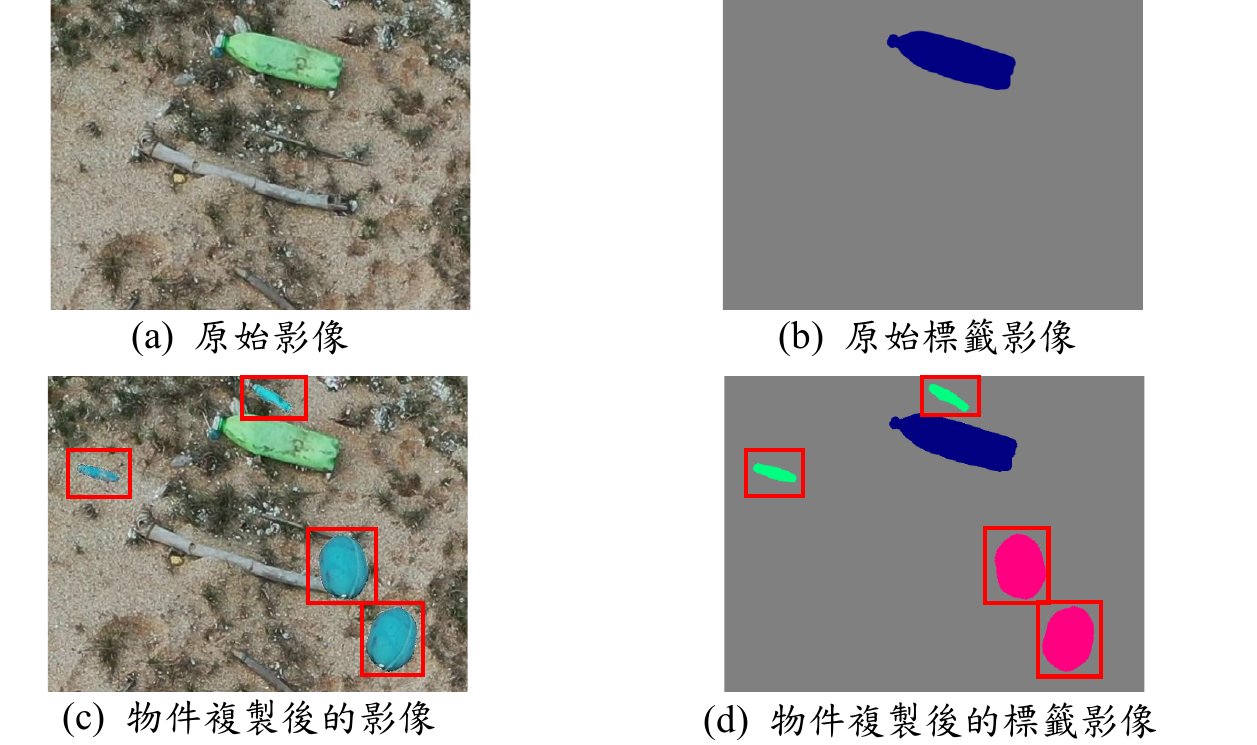
物件複製貼上的結果與對應標籤,紅框是貼上去的物件(取自專題論文圖 7.6)。
擴充之後,浮球的標註從 1,727 個增加到 12,030 個,浮標從 5,676 個增加到 12,218 個。
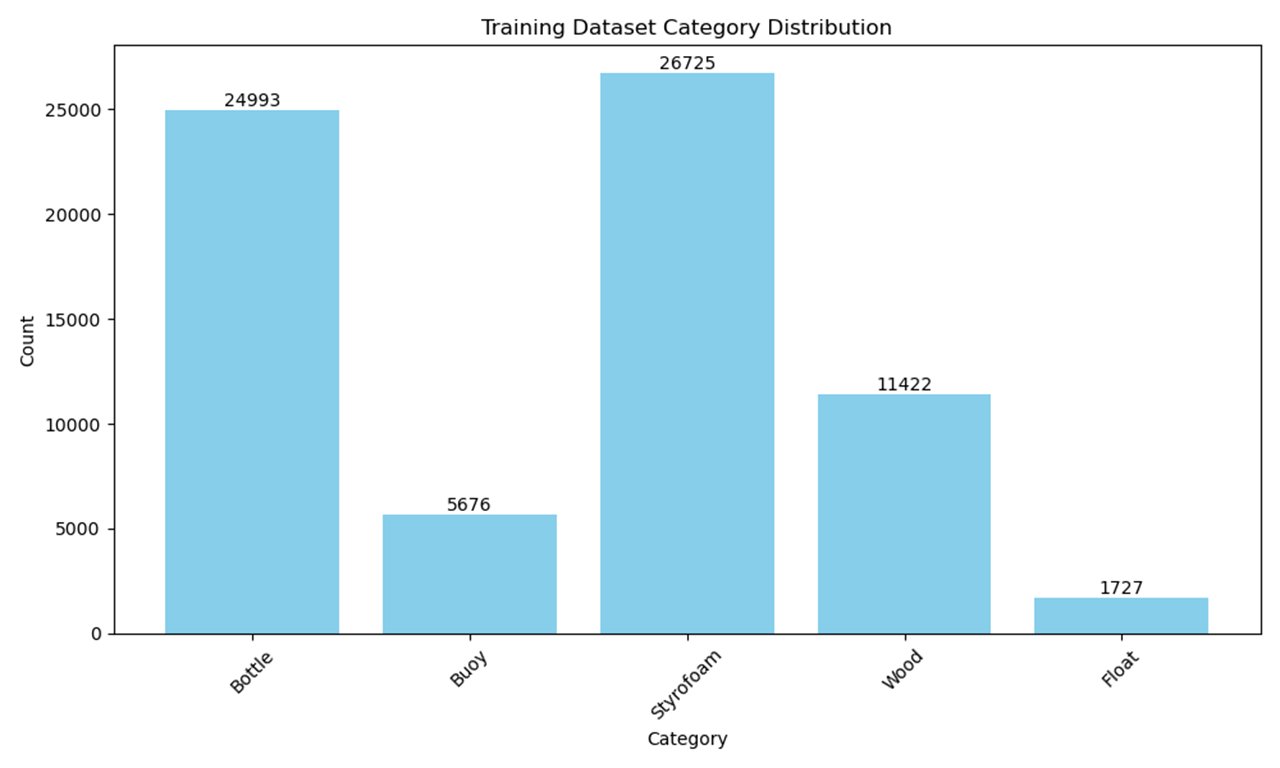
擴充前
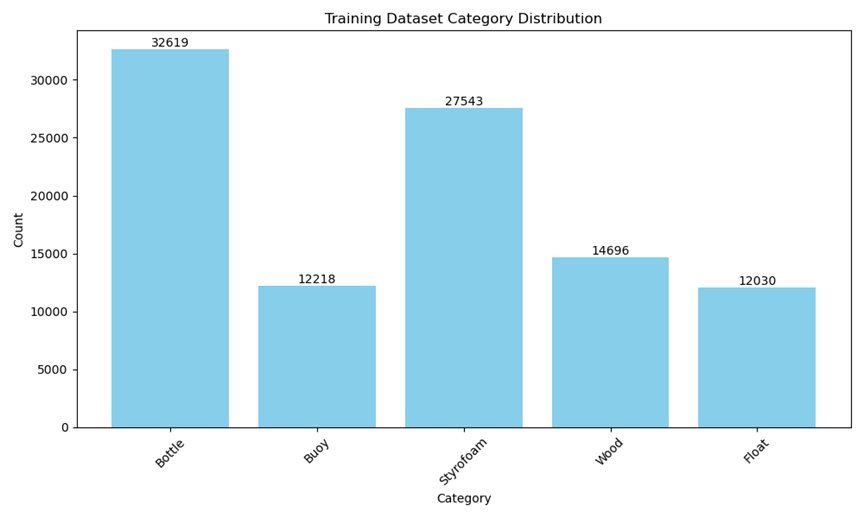
擴充後
各類別的標註數量(取自專題論文圖 5.2、圖 7.7)。圖中 Float 是浮球、Buoy 是浮標、Bottle 是寶特瓶、Styrofoam 是保麗龍、Wood 是木材。
訓練設定
| 項目 | 設定 |
|---|---|
| 訓練/測試影像 | 4,709 張/523 張 |
| 模型 | CenterMask2 |
| 迭代次數/Batch | 500,000/12 |
| 初始學習率 | 0.001 |
| 學習率調整 | 第 47 萬、49 萬次迭代時各降為 1/10 |
測試集的辨識結果
訓練完成後,用 523 張測試影像評估模型,再從混淆矩陣算出每一類的 Precision、Recall 與 F1-Score:
| 類別 | Precision | Recall | F1-Score |
|---|---|---|---|
| 浮球 | 0.83 | 0.76 | 0.79 |
| 木材 | 0.54 | 0.46 | 0.49 |
| 浮標 | 0.54 | 0.43 | 0.48 |
| 保麗龍 | 0.63 | 0.35 | 0.45 |
| 寶特瓶 | 0.34 | 0.22 | 0.27 |
浮球外形規則、顏色鮮明,辨識最穩定。保麗龍與寶特瓶的 Recall 明顯偏低,代表漏檢多。
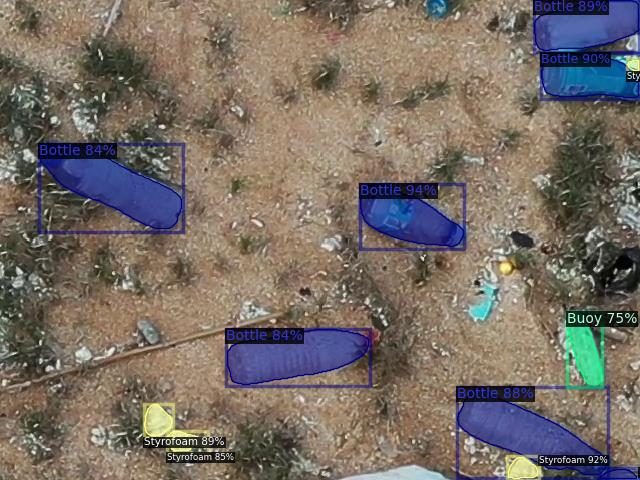
模型在一張 640 × 480 小影像上的輸出:每個物件有邊界框、遮罩、類別與信心分數(取自專題論文圖 5.5)。
錯誤分析:保麗龍與寶特瓶
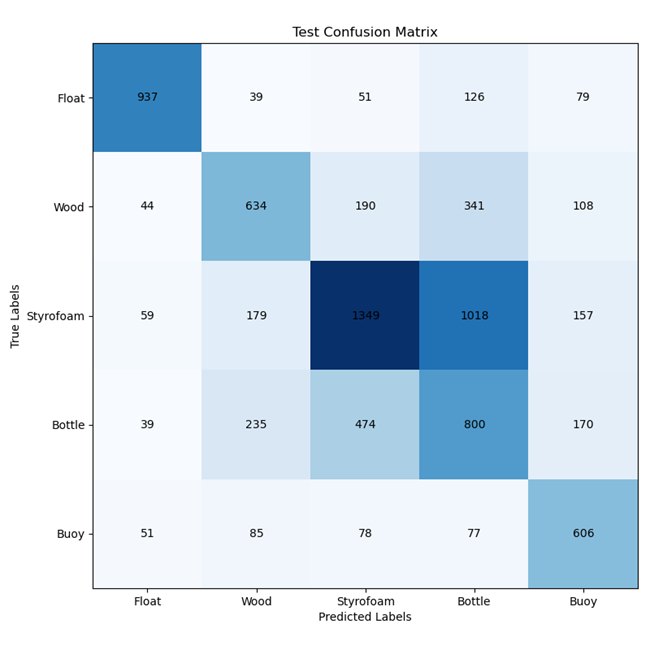
測試集混淆矩陣,縱軸是實際類別,橫軸是模型預測的類別(取自專題論文圖 7.11)。
把測試結果按類別拆開來看,類別之間最主要的錯誤是保麗龍與寶特瓶互相誤判:實際是保麗龍、被判成寶特瓶的有 1,018 筆;實際是寶特瓶、被判成保麗龍的有 474 筆。
值得注意的是,寶特瓶在原始資料中有 24,993 個標註,僅次於保麗龍,是樣本最多的類別之一,辨識效果卻最差。問題可能不只在樣本數量,也和物件尺寸、外觀相似與背景複雜度有關。這是我想進一步驗證的地方。
研究限制與後續工作
目前的測試結果是整體平均,沒有依物件尺寸、拍攝高度、光線或背景分組,所以還回答不了「模型最小能辨識多少像素的垃圾」這類問題。這個問題是參加競賽時評審問的,當時我們沒有實驗數據可以回答。
後續可以依物件的像素面積把測試資料分組,分別計算各組的 Recall,找出辨識率明顯下降的尺寸界線,作為無人機拍攝高度的設計依據。針對小而相似的物件,也可以比較提高輸入解析度、不同的切片方式、更有針對性的資料增強,以及不同模型架構的效果。
延伸閱讀
- Lee & Park, CenterMask: Real-Time Anchor-Free Instance Segmentation, CVPR 2020 / 官方 repo
- 空拍影像辨識技術地圖:分割策略、模型架構與影像拼接的技術取捨 — 這套系統用到的實例分割、評估指標與拼接原理